

Consumo y límites
7 min de lectura
Un escalón más que la facturación, para entender y controlar lo que consumen tus agentes.
Estadísticas
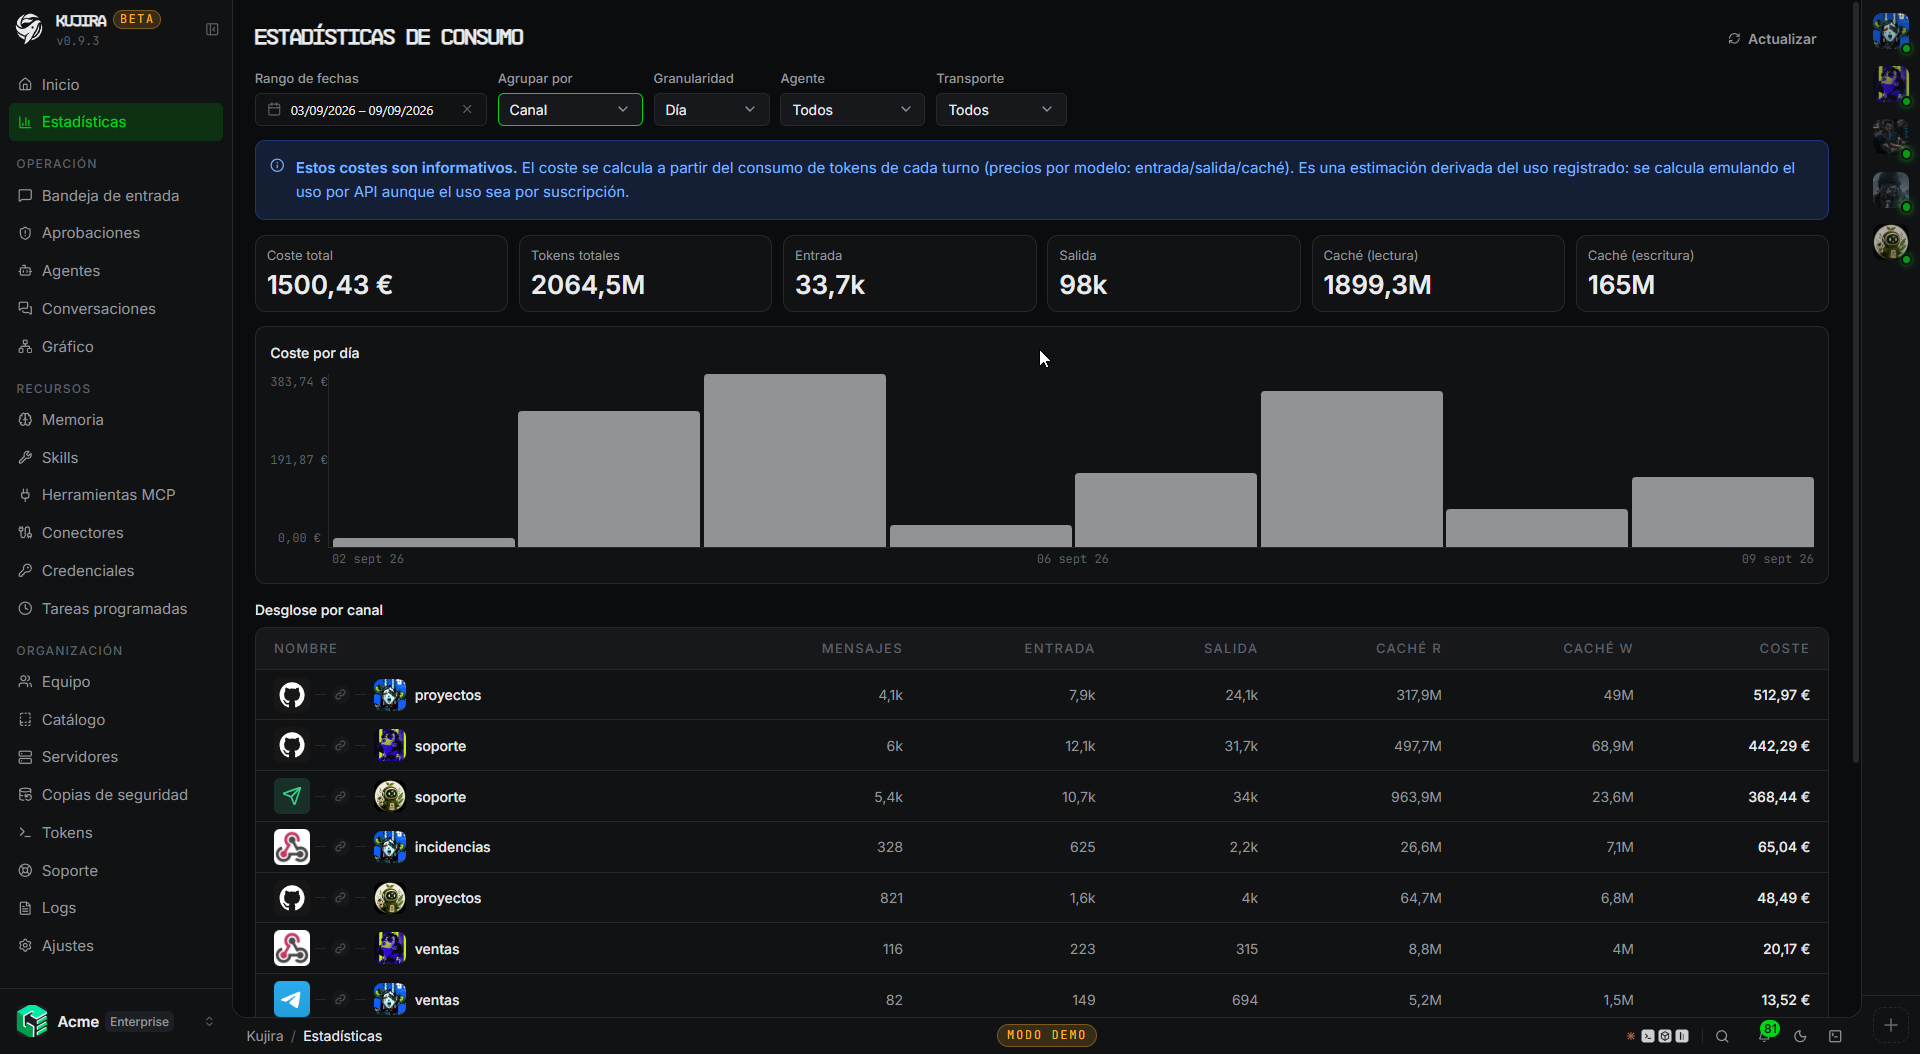
En Estadísticas ves el consumo registrado en cada respuesta de modelo. El selector superior combina un rango de fechas, un filtro de agente o transporte, la granularidad de la gráfica y el criterio de agrupación. Debajo, la gráfica muestra la evolución temporal y la tabla explica de dónde sale el total.
Qué cuenta
Cada turno guarda los tokens que informa el modelo, y Consumo los suma: todo va en tokens, no en euros. Si tus agentes trabajan con una suscripción, lo que pagas no depende de cada turno.
Los totales separan estas cuatro partes:
| Dato | Qué representa |
|---|---|
| Entrada | Los tokens nuevos que se envían al modelo: tu mensaje, instrucciones y el contexto que no estaba reutilizado. |
| Salida | Los tokens generados por el modelo al responder o ejecutar una tarea. |
| Caché (lectura) | Contexto que el proveedor reutiliza desde caché. Sigue contando como contexto, aunque al proveedor le cuesta mucho menos que volver a procesarlo. |
| Caché (escritura) | Contexto que se prepara para poder reutilizarse después. |
Tokens totales suma las cuatro categorías. Por eso es normal que una conversación larga tenga muchos más tokens de caché que de entrada o salida: el agente puede estar recuperando el mismo contexto sin reenviarlo por completo.
Si la salida es alta, haz las respuestas más concretas
Desde Configuración > Comportamiento del agente puedes elegir menos Detalle, un formato Escaneable y Un solo mensaje. Son buenas opciones para agentes operativos que no necesitan explicar cada paso.
Esto reduce el texto que el agente entrega y puede reducir los tokens de salida; no elimina el razonamiento ni el contexto que necesite para hacer el trabajo.
Agrupar y acotar el análisis
Elige primero un periodo y después la dimensión que responde a tu pregunta:
| Agrupar por | Úsalo para saber |
|---|---|
| Agente | Qué agente concentra el consumo. Es el mejor punto de partida ante un incremento inesperado. |
| Canal | Qué canal concreto del agente consume más: por ejemplo, un chat interno, una sala o un webhook. |
| Transporte | Qué integración origina el consumo: interno, Telegram, Discord, Slack, correo, webhook u otra. |
| Ámbito | La diferencia entre comunicación interna y externa. |
| Conversación | El hilo exacto que está generando consumo; útil para investigar un caso concreto. |
| Contacto | La persona, grupo o sistema con el que se acumula más actividad. |
| Modelo | Cómo se reparte el uso entre modelos. |
| Tarea programada | Qué tarea recurrente está consumiendo. Los turnos que no proceden de una tarea aparecen como Sin tarea programada. |
Los filtros de Agente y Transporte reducen el universo antes de agrupar. Por ejemplo, filtra un agente y agrupa por Canal para localizar por dónde trabaja; o filtra Telegram y agrupa por Contacto para distinguir si el volumen viene de una conversación concreta o de muchas pequeñas.
La granularidad solo cambia el detalle de la gráfica, no el total: usa Hora para investigar un pico reciente, Día para seguimiento habitual, Semana para periodos de varios meses y Mes para una vista anual.
Una forma práctica de investigar un aumento
Empieza agrupando por Agente. Después filtra el que haya crecido y prueba Canal, Conversación y Modelo. La tabla te dirá si el origen son más mensajes, respuestas más largas, mucho contexto en caché o un cambio de modelo.
Ritmo máximo de consumo
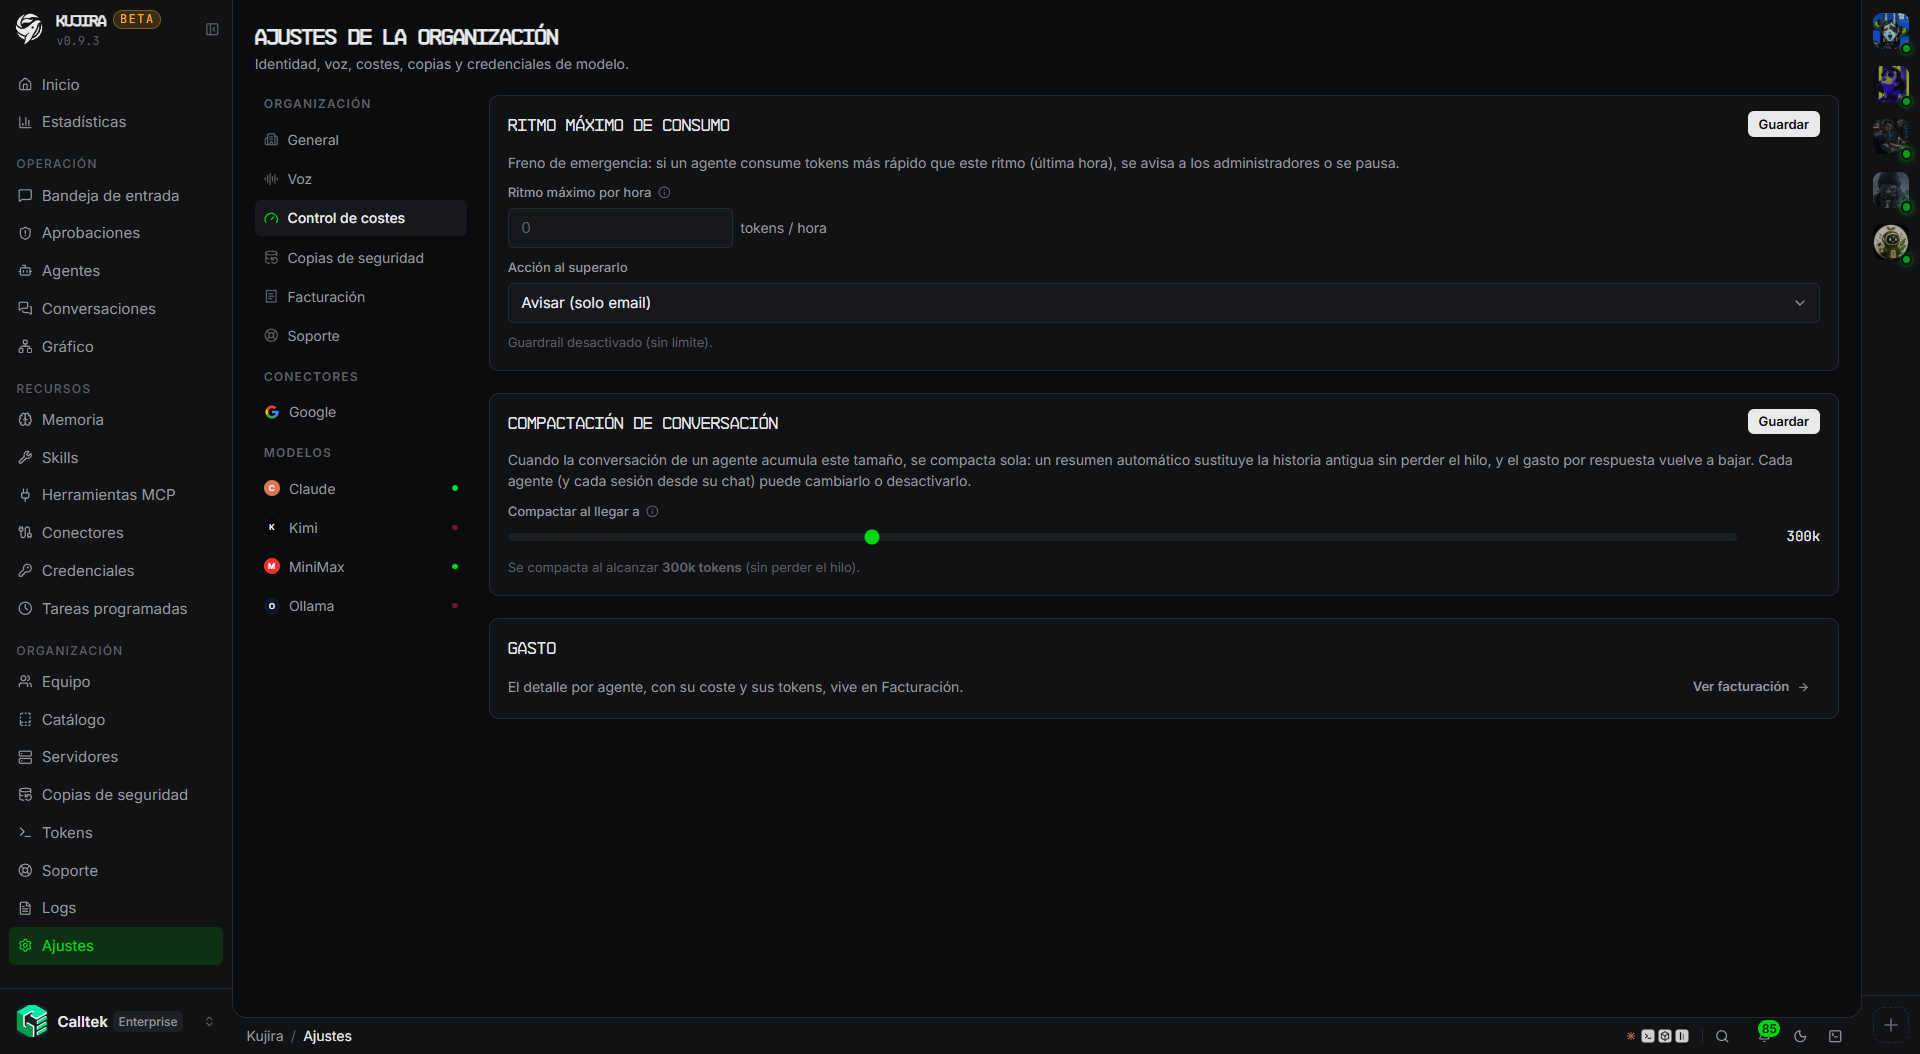
El freno de emergencia. Si un agente consume tokens más rápido que el ritmo que fijes —mirando la última hora—, Kujira avisa a los administradores o pausa al agente, según lo que elijas.
Se pone por defecto en Ajustes › Control de costes y cada agente puede heredarlo, apagarlo o llevar el suyo. Si no configuras nada, se aplica el tope de tu plan, y ese tope sigue valiendo aunque apagues el freno de un agente: solo puedes subirlo o bajarlo, no quitarlo.
El aviso de un agente que pasa de su ritmo llega como mucho una vez cada cuatro horas por agente y acción, aunque siga por encima todo ese tiempo. Vale igual para el correo, el móvil y la campana del panel. Ver Cuántos avisos llegan.
En pantallas anchas, la ficha de cada agente lleva bajo las pestañas una línea con lo consumido en la última hora frente al tope que le aplica: en el color normal, ámbar pasada la mitad —ahí llega el primer aviso, que nunca frena— y roja pasado el tope, que es cuando se pausa si lo tienes elegido. Al dejar el ratón encima dice si al llegar avisa o pausa, y la cifra exacta. Si no hay tope que aplicar, no aparece. La ven quienes pueden ver el gasto de la organización, y cada uno puede ocultarla en Mi cuenta › Apariencia › Mostrar control de coste; se guarda en ese navegador, no en la cuenta.
Por qué tokens y no euros
Bajo suscripción el euro por turno es ficticio, así que un tope en dinero frenaría a unos agentes sí y a otros no según cómo se pague su modelo. El ritmo de tokens mide lo mismo en todos los casos.
El tope máximo depende de tu plan. Ver Planes y límites.
Compactación de conversación
Cuando una conversación acumula mucho contexto, cada respuesta cuesta más. Al llegar al umbral, la conversación se compacta sola: un resumen automático sustituye lo antiguo sin perder el hilo, y el gasto por respuesta vuelve a bajar.
Una organización nueva no adelanta nada: cada conversación aprovecha toda la ventana de contexto de su modelo y se compacta al llenarse. Compactar antes ahorra, pero cuesta un turno entero y pierde detalle, así que cuándo hacerlo lo decide cada organización.
Si la tuya es anterior a septiembre de 2026, conserva como tope la cifra que ya tenía —300.000 tokens, salvo que la hubierais cambiado—, así que nada se movió de un día para otro. Para aprovechar la ventana entera, vacía ese tope.
En Ajustes › Control de costes hay dos ajustes, y se compacta con el primero que llegue:
- Porcentaje de la ventana. Significa lo mismo en toda la organización aunque sus agentes usen modelos distintos: un 30 % son unos 300.000 tokens en un modelo de 1M y unos 60.000 en uno de 200k. Al 100 % no se adelanta nada.
- Tope de tokens, opcional. Compacta al llegar a esa cifra aunque el porcentaje llegue después. Es lo que conviene poner para contener el gasto en los modelos de ventana muy grande.
Cada agente puede heredar ese ajuste, no compactar nunca o fijar su propio umbral en tokens, y cada sesión puede hacer lo mismo desde el chat o desde la lista de conversaciones. Cambiar la compactación se aplica desde el siguiente mensaje, sin reiniciar el agente. Ver Sesiones.
Un umbral no se aplica en dos casos. Si llega a la ventana del modelo no adelanta nada, porque ahí la conversación ya se compacta al llenarse. Y si no llega a 20.000 tokens, tampoco: el resumen sustituiría a lo que el agente carga al arrancar.
Dos casos en los que sí conviene tocarlo
MiniMax M3 con pago por uso cobra el doble por encima de 512.000 tokens de entrada. Con conversaciones largas en ese modelo, pon el tope en 500.000.
Ollama no guarda caché de contexto: relee la conversación entera en cada turno, así que las respuestas se vuelven más lentas según crece. Bajar el porcentaje lo corrige.
Dónde mirar primero si algo se dispara
En Estadísticas, agrupa por agente y mira la gráfica: casi siempre es un agente concreto, un canal que se ha vuelto ruidoso o una tarea programada demasiado frecuente.